
El olfato es uno de los sentidos más difíciles de traducir a números. En visión se puede medir la longitud de onda de la luz y en audición la frecuencia del sonido, pero con los olores la relación entre una mezcla química y lo que una persona percibe sigue siendo mucho menos directa. Un nuevo estudio publicado en PNAS sugiere que esa brecha quizá no sea tan intratable como parecía: modelos de aprendizaje automático lograron anticipar con bastante precisión qué tan parecidas o distintas resultan para las personas mezclas complejas de olores.
La pregunta central no era si una molécula huele a rosa, humo o cítrico, sino algo más difícil: cómo comparar mezclas que contienen muchos compuestos al mismo tiempo. Eso importa porque la mayoría de los olores del mundo real no son sustancias puras, sino combinaciones. El aroma de un café, una fruta o un perfume surge de conjuntos complejos de moléculas, y predecir cómo se sentirán en conjunto es uno de los grandes problemas abiertos de la ciencia del olfato.
Para abordarlo, el equipo trabajó con un desafío colaborativo en el que distintos grupos intentaron predecir distancias perceptuales entre pares de mezclas odoríferas. En términos simples, buscaron estimar cuándo dos mezclas serían juzgadas como muy parecidas y cuándo como claramente distintas. Los modelos se probaron primero sobre un conjunto oculto de 46 pares y luego sobre una validación independiente con 50 pares nuevos, diseñados específicamente para poner a prueba si el método resistía fuera de los datos iniciales.
El resultado fue mejor de lo esperado. Según el paper, el modelo conjunto que reunió a los enfoques con mejor desempeño redujo de forma importante el error frente a métodos previos y mejoró también la correlación entre la predicción computacional y lo que reportaron las personas. Lo llamativo es que gran parte de esa mejora surgió de un espacio semántico compacto construido a partir de moléculas individuales. En otras palabras, el sistema no necesitó inventar una lógica completamente nueva para las mezclas: pudo apoyarse en información extraída de componentes simples y aún así describir bastante bien cómo se perciben combinaciones complejas.
Ese punto tiene interés más allá del rendimiento técnico. Si la percepción de mezclas puede organizarse con reglas parecidas a las que ya sirven para describir moléculas aisladas, entonces el olfato podría empezar a entrar en una etapa más cuantitativa. Eso abriría la puerta a comparar olores con herramientas más consistentes, en vez de depender solo de paneles humanos o de descripciones subjetivas difíciles de estandarizar.
Las posibles aplicaciones son tentadoras, pero todavía están lejos de ser productos listos para usar. Un marco así podría ayudar en el futuro a diseñar fragancias, controlar calidad en alimentos, mejorar sensores ambientales o avanzar hacia formas de “olfacción digital”, es decir, sistemas capaces de medir, clasificar o reproducir experiencias olorosas de manera más sistemática. Pero el estudio no resuelve por sí solo cómo capturar cualquier olor del mundo ni cómo reconstruirlo a demanda en un aparato.
También hay límites claros. El modelo se entrenó y evaluó con conjuntos experimentales específicos y con una tarea muy delimitada: predecir distancias perceptuales entre mezclas. Eso no equivale a entender por completo cómo el cerebro construye la experiencia del olfato, ni garantiza que el sistema funcione igual de bien con todos los contextos culturales, concentraciones o combinaciones químicas posibles. Como ocurre con muchos avances en inteligencia artificial, una mejora estadística importante no es lo mismo que una teoría completa del fenómeno.
Aún así, el trabajo deja una señal fuerte. Durante años, la complejidad de los olores hizo pensar que las mezclas serían casi imposibles de ordenar con precisión. Este estudio no cierra ese problema, pero muestra que puede atacarse con mejores resultados de los previstos y con métodos reproducibles. Si esa línea se consolida, el olfato podría empezar a parecerse un poco menos a un territorio inmedible y un poco más a un sistema que la ciencia puede cartografiar.
Phys.org · Imagen acompañante del artículo fuente; atribución preservada · Fuente de imagen
Satarifard, V., Sisson, L., Han, Y., Ilídio, P., Hladiš, M., Lalis, M., Song, X., Yang, T., Yin, W., Ravia, A., et al. (2026). A semantic-based community model for high-fidelity tuning of olfactory mixture distances. Proceedings of the National Academy of Sciences, 123(32), e2611057123. https://doi.org/10.1073/pnas.2611057123
Relacionadas por categoría
Ver mas
Un sistema convierte artículos científicos en asistentes reutilizables
Un método empaqueta texto, código, datos y flujos de trabajo de algunos estudios para que una IA pueda ejecutar análisis y responder consultas en lenguaje natural.
Un cúbit lógico redujo sus errores a unos pocos por millón de ciclos
Un experimento con iones atrapados mostró que aumentar la protección de un cúbit lógico redujo de forma marcada sus errores. El resultado es prometedor, pero todavía es un preprint y una demostración de pequeña escala.
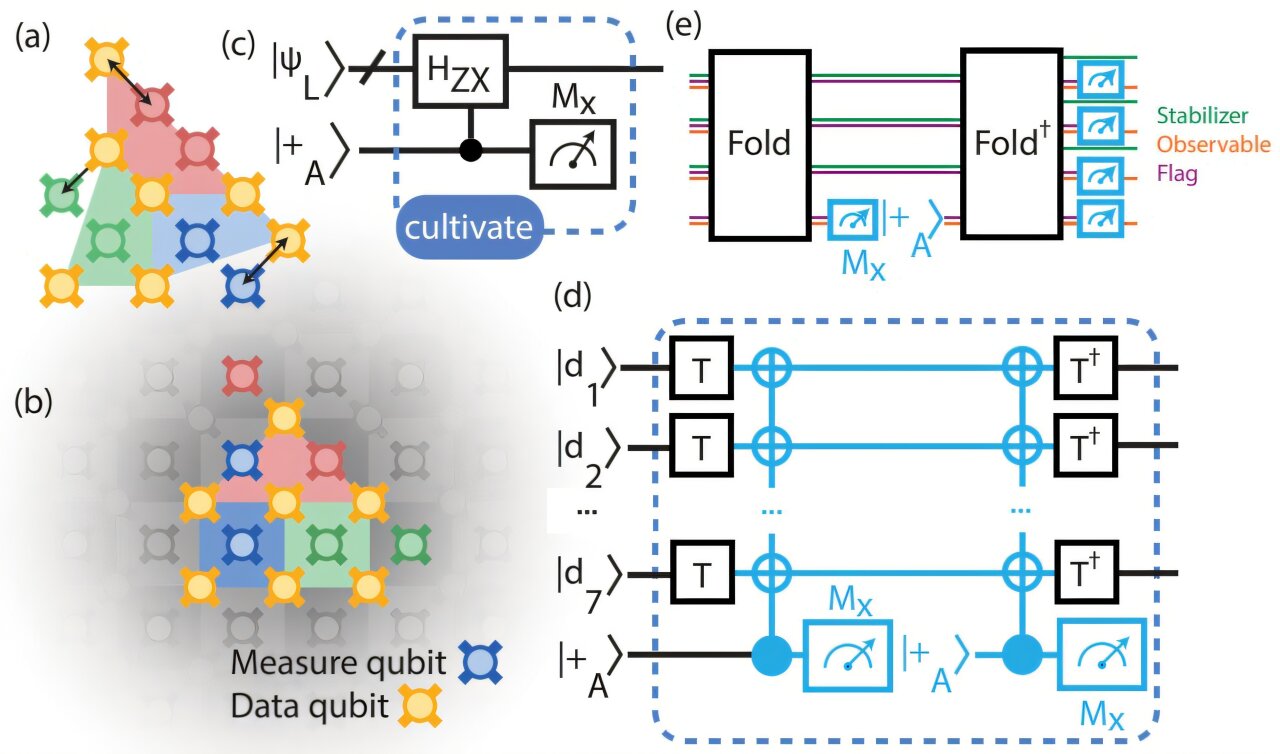
Un chip cuántico depura un estado clave y reduce sus errores 40 veces
Un experimento en un procesador superconductivo logró seleccionar estados cuánticos mucho más precisos, un paso necesario para cálculos confiables a gran escala.
Más de la misma fuente
Ver mas
Un modelo explora choques de estrellas en el universo temprano
Un modelo que combina simulaciones cosmológicas y dinámica estelar propone que las colisiones entre estrellas pudieron ser habituales en cúmulos muy densos del cosmos temprano.

Un archivo de ARN permite reconstruir qué hizo una célula días antes
Una herramienta creada en células humanas cultivadas conserva mensajes de ARN y permite recuperar respuestas genéticas breves que una medición tardía ya no detectaría.

Un cuásar polvoriento muestra lo que las búsquedas del universo temprano pueden pasar por alto
JWST y ALMA observaron un cuásar cuando el universo tenía menos de mil millones de años y revelaron cómo el polvo puede ocultar parte de su actividad.
Más del mismo autor
Ver mas
El rol social cambia el crecimiento y la conducta de los peces payaso
En un experimento con peces payaso juveniles, los individuos que se volvieron dominantes crecieron más, comieron más y mostraron más agresividad que sus rivales y que peces mantenidos solos.
Los cometas difícilmente aportaron ingredientes clave para el origen de la vida
Simulaciones de impactos sugieren que las condiciones necesarias para que los cometas llevaran compuestos orgánicos útiles a la Tierra temprana fueron excepcionales.
Una ruta química devuelve siliconas difíciles de reciclar a una materia prima
Un estudio propone desarmar siliconas resistentes y recuperar diclorosilano, una molécula que puede volver a emplearse para fabricar estos materiales.